Le vrai problème de l’organisation du travail n’est pas que nous manquons d’informations. C’est que nous devons constamment décider où les ranger.
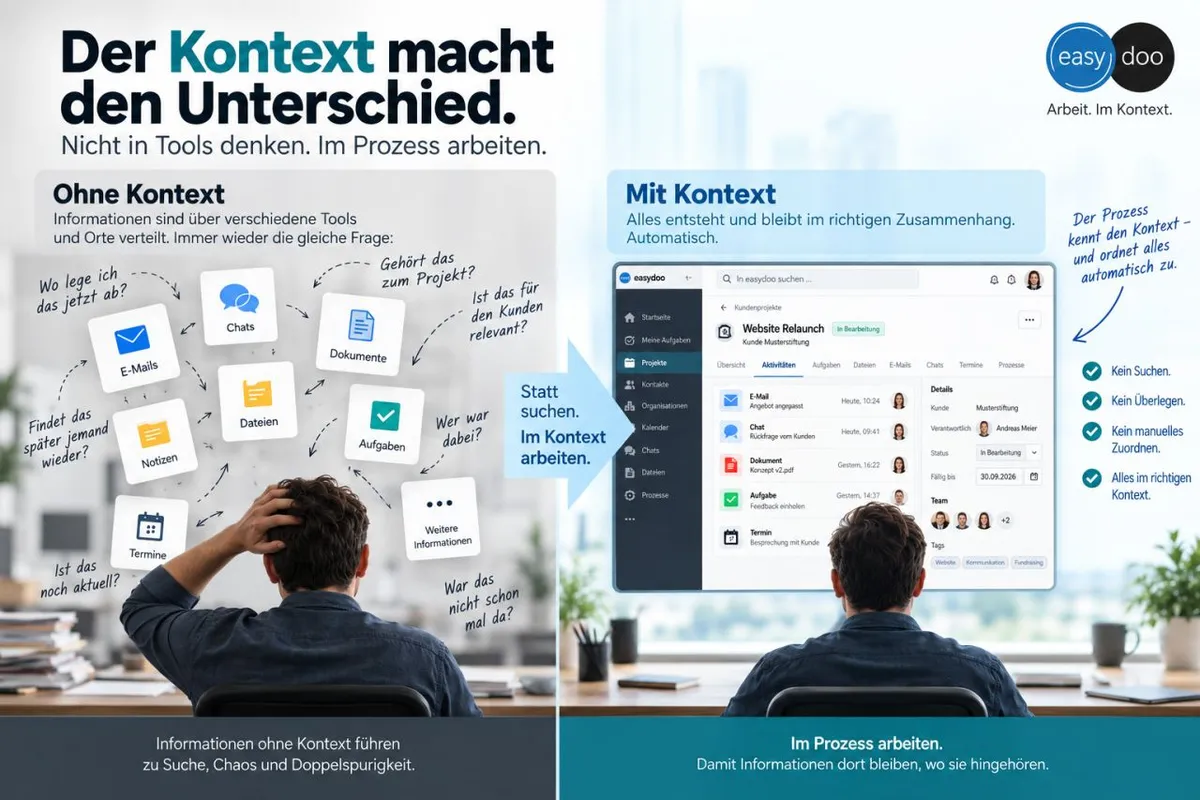
Un e-mail arrive. Une discussion démarre. Un document est créé. Une décision est prise. Une tâche s’ajoute. Et à chaque fois, la même question : où dois-je classer cela maintenant, pour que quelqu’un le retrouve plus tard ? Dans le CRM ? Dans la GED ? Dans Teams ? Dans le dossier du projet ? Sur la tâche ? Ou finalement dans la boîte e-mail ?
Le processus devrait connaître le contexte
Je pense que nous devons repenser l’organisation du travail. Ce n’est pas à la personne de saisir le contexte d’une information — c’est le processus qui devrait déjà le connaître.
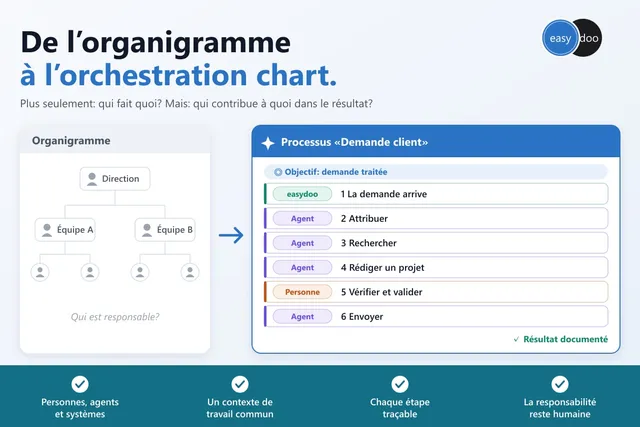
Lorsque je traite un dossier client, le processus sait sur quoi je travaille. Il connaît le client, le dossier, l’étape en cours, les personnes impliquées et les activités précédentes.
Cela indique aussi clairement où doit aller la prochaine information : un document, une discussion, un e-mail, une note, une tâche, un rendez-vous, une décision. Tout naît dans le contexte du travail — et y reste.
Je n’ai rien à indexer. Je n’ai pas à chercher un emplacement de classement. Je n’ai pas à me demander dans quel outil quelqu’un cherchera plus tard. Parce que je travaille dans le processus — et que le processus connaît le contexte.
La différence essentielle
Pour moi, c’est la différence essentielle entre simplement numériser le travail et une véritable bonne organisation numérique du travail : les informations ne s’organisent pas selon les outils et les emplacements de stockage, mais selon le contexte dans lequel elles naissent. Et c’est précisément là qu’elles doivent rester repérables.